Zum Hauptinhalt springen
SEO-News

Retrieve for Train: Google stellt neuen Ansatz für Query Fan-Out vor

Christian Kunz
27. September 2026
Zuletzt aktualisiert: 27. September 2026
Google Query Fan-Out: Fächer

Bild KI-generiert

Google kann die Qualität und die Geschwindigkeit von Fan-Out Queries mit einem neuen Ansatz deutlich steigern: Retrieve for Train setzt auf Offline-Trainings und Vielfalt der Fragen.

 

 Anzeige

Mithilfe einer neuen Technologie, dem sogenannten Retrieve for Train, kann Google die Qualität von Inhalten, die beim Query Fan-Out im Zusammenhang mit einer Suchanfrage generiert werden, nach eigenen Angaben deutlich steigern, und das in kürzerer Zeit.

Beim klassischen Query Fan-Out wird eine vom Nutzer gestellte Suchanfrage automatisch in mehrere verwandte Teil-Anfragen zerlegt. Das Ziel besteht darin, ein stimmiges und sich ergänzendes Gesamtergebnis zu liefern, das sogenannte Slate, anstatt lediglich zehn minimale Abwandlungen desselben Treffers anzuzeigen.

Ein praktisches Beispiel hierfür ist die Suche nach einer Camping-Ausrüstung: Nutzer erwarten in diesem Fall nicht zehn verschiedene Vier-Personen-Zelte, sondern eine zusammenhängende Zusammenstellung aus Zelt, Schlafsack, Campingkocher und Stirnlampe.

SEO-Beratung: Wir sind Ihre Experten

Wir bringen gemeinsam Ihre Website nach vorne. Profitieren Sie von jahrelanger SEO-Erfahrung.
Christian Kunz
Christian Kunz
SEO Experte
David Wulf
David Wulf
SEO Experte
Sven Häwel
Sven Häwel
Offpage-Experte

Schwachstellen klassischer KIs beim Fan-Out

Das Ausführen von Query Fan-Out mit herkömmlichen LLMs stößt auf zwei Hürden:

  1. Paraphrastic Collapse: Standard-LLMs sind nicht auf die mathematische Struktur spezifischer Datenbanken optimiert. Ohne gezielte Anpassung neigen sie dazu, nahezu synonyme Suchbegriffe zu erzeugen, anstatt semantisch unterschiedliche Aspekte zu erkunden. Bei der Eingabe von "Bohemian festival style" generieren herkömmliche KIs beispielsweise redundante Abwandlungen wie "bohemian festival fashion" oder "bohemian festival clothes". Dadurch entstehen sehr ähnliche Ergebnisse, während fachlich relevante Kategorien wie Fransenjacken, Häkelkleider oder Wildlederstiefel unberücksichtigt bleiben.

  2. Autoregressive Latenz-Engpässe: Klassische Sprachmodelle erzeugen Text sequenziell Token für Token. Um eine komplexe Anfrage sinnvoll zu zerlegen, benötigen sie in der Chain-of-Thought hunderte Zwischen-Tokens. Wenn mehrere Sub-Queries parallel verarbeitet werden müssen, erfordert das eine hohe Rechenleistung. Unter hoher Auslastung steigen die Antwortzeiten auf bis zu 50 Sekunden an. Für Suchmaschinen wie Google ist das ungeeignet.

Funktionsweise des Retrieve-for-Train-Frameworks

Das von Google Research entwickelte Retrieve-for-Train-Framework verlagert den rechenintensiven Denkprozess vollständig aus der Echtzeit-Suche in eine einmalige Offline-Trainingsphase. Das System gliedert sich in drei Schritte:

  • Schritt 1: RL-Training des Sprachmodells (Fan-Out LM Training):
    Ein Sprachmodell wie Gemma3-4B oder Qwen3-4B wird mittels Reinforcement Learning trainiert, genau 10 Sub-Queries pro Anfrage zu erzeugen. Die Bewertung erfolgt über ein mathematisches Belohnungssystem, das drei Faktoren ausgleicht:

    • Groundedness (Datenbank-Verankerung): Stellt sicher, dass jede Sub-Query einem real existierenden Eintrag in der Datenbank entspricht.
    • Diversity (Vielfalt): Wird über das gesamte Set gemessen, um eine breite semantische Streuung zu erzwingen.
    • Alignment (Ausrichtung): Verankert die Sub-Queries an der ursprünglichen Nutzeranfrage, um ein Abdriften des Themas zu verhindern.
  • Schritt 2: Synthese von Trainingsdaten (Supervision Synthesis):
    Das eingefrorene, per RL optimierte Sprachmodell erstellt offline Paare aus ursprünglicher Anfrage und Ziel-Set.
  • Schritt 3: Training des Diffusion-Retrievers (Diffusive Retriever Training):
    Ein kompaktes Diffusion-Modell Parametern lernt, Query-Embeddings in einem einzigen, nicht-autoregressiven Durchgang direkt auf ein vollständiges Set von Ziel-Embeddings abzubilden.

Der Ablauf erfolgt in drei aufeinander aufbauenden Blöcken:
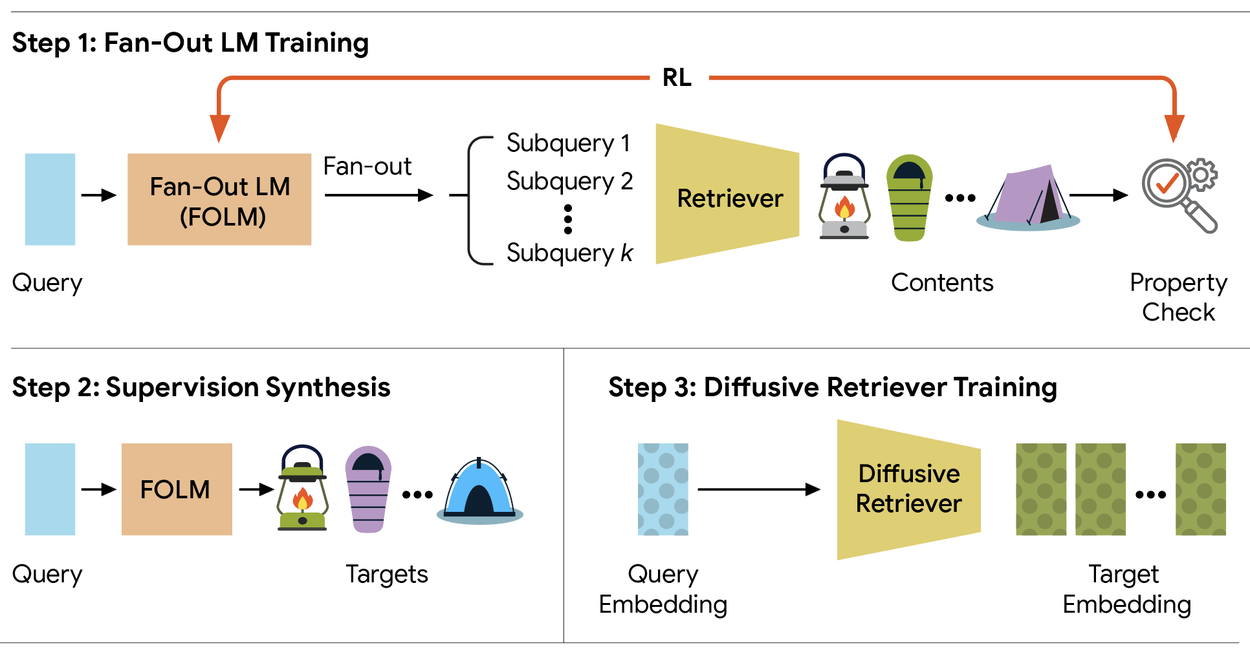
  1. Fan-Out LM Training: Zeigt das RL-unterstützte Training des Sprachmodells (FOLM), das durch die kombinierte Belohnungsfunktion gesteuert wird.
  2. Supervision Synthesis: Das trainierte FOLM wird zur automatischen Erstellung von Trainingsdatenpaaren genutzt.
  3. Diffusive Retriever Training: das finale Training, bei dem das Diffusion-Modell lernt, Embeddings des Inhalts direkt aus den Abfrage-Embeddings zu samplen.


Google Retrieve for Train Framework

Abbildung: Google Retrieve for Train Framework

Wenn ein Nutzer eine Suchanfrage stellt, kommt das große Sprachmodell aus der Trainingsphase nicht mehr zum Einsatz. Der zeitintensive Denkprozess wurde im Offline-Training bereits vollständig in das Diffusion-Modell übersetzt.

Der Fan-Out-Prozess läuft bei einer Live-Anfrage in drei schnellen Schritten ab:

  1. Vektorisierung der Anfrage:
    Die Suchanfrage des Nutzers wird zuerst in einen mathematischen Vektor – ein sogenanntes Query-Embedding – im kontinuierlichen Vektorraum umgewandelt.

  2. Paralleles Sampling per Diffusion-Modell: Das kleine Diffusion-Modell nimmt dieses Query-Embedding entgegen und erzeugt in einem einzigen, Durchgang direkt ein komplettes Set von Ziel-Embeddings. Weil das Modell direkt auf Vektorebene arbeitet, erzeugt es keine einzelnen Text-Tokens und benötigt keine Zwischenschritte.

  3. Direkter Datenbank-Abruf: Mit den erzeugten Ziel-Embeddings greift das System sofort auf die Vektordatenbank zu und holt die dazugehörigen echten Treffer heraus.

Das System erzielte eine 12- bis 20-fache Beschleunigung gegenüber herkömmlichen autoregressiven Ansätzen. Statt Latenzen von nahezu 50 Sekunden antwortete das Modell in einer Spanne von unter einer Sekunde bis zu wenigen Sekunden bei deutlich reduzierten Rechenkosten.

Mögliche Auswirkungen auf SEO / GEO

Webseiten, die für die im Hintergrund generierten Sub-Queries ranken, haben bessere Chancen, als Quelle in Googles AI Overviews zitiert werden. Es gewinnen solche Webseiten an Sichtbarkeit, die ein Thema in der Tiefe abdecken (Topical Authority) und alle bzw. möglichst viele relevanten Facetten beantworten.

Weil sich mit dem neuen Retrieve-for-Train-Ansatz auch die erzeugten Sub-Queries ändern, muss dies in der SEO-Strategie und den bereitgestellten Inhalten der Websites berücksichtigt werden.

Die meisten der von KIs erzeugten Sub-Queries haben kein klassisches, monatliches Suchvolumen in Keyword-Tools. SEO-Strategien müssen sich deshalb an typischen Intentions-Mustern wie Vergleiche, Spezifikationen, EEAT-Nachweise oder bestimmten Use Cases orientieren anstatt an festen Suchbegriffen.
Christian Kunz

Von Christian Kunz

SEO-Experte.
Sie benötigen Beratung für Ihre Webseite? Klicken Sie hier


SEO-Newsletter bestellen

Im monatlichen SEO-Newsletter erhaltet Ihr eine Übersicht der jeweils zehn wichtigsten SEO-Meldungen des Monats. Mit dem SEO-Newsletter bleibt Ihr auf dem Laufenden.

Verwandte Beiträge

Anzeige

rnkeffect

Premium-Partner (Anzeige)


Anzeigen
Generative Engine Optimization 2026 Buch


Farbentour


Onsite-Optimierung

Onsite-Optimierung


Sprecher auf

SEO- und Suchmaschinenblogs

SEO-FAQ

Bild © FM2 - Fotolia.com

SEO selber machen

SEO selber machen

Bekannt aus

Website Boosting


Internet World Business

SEO United


The SEM Post


Webselling

Jetzt vernetzen

SEO-Glossar

SEO-Glossar